Fiş OCR'ı nasıl yaptım: bulutsuz, yapay zekâsız, ölçülerek
Fiş fotoğraflarından firma, VKN, tarih, KDV ve toplamı çıkaran yerel bir aracı nasıl geliştirdiğimi, nasıl test ettiğimi ve bir sunucuya API olarak nasıl kurduğumu anlatıyorum.
Bir muhasebe sürecinde yüzlerce market ve restoran fişinin firma adı, vergi numarası, tarih, KDV ve toplam bilgisi elle giriliyordu. İstek netti: fotoğraflar bir klasöre atılsın, sonuç tek bir dosya olarak çıksın. Kısıtlar da netti: bulut servisi yok, yapay zekâ (LLM) yok, mümkünse sıradan bir işlemcide çalışsın.
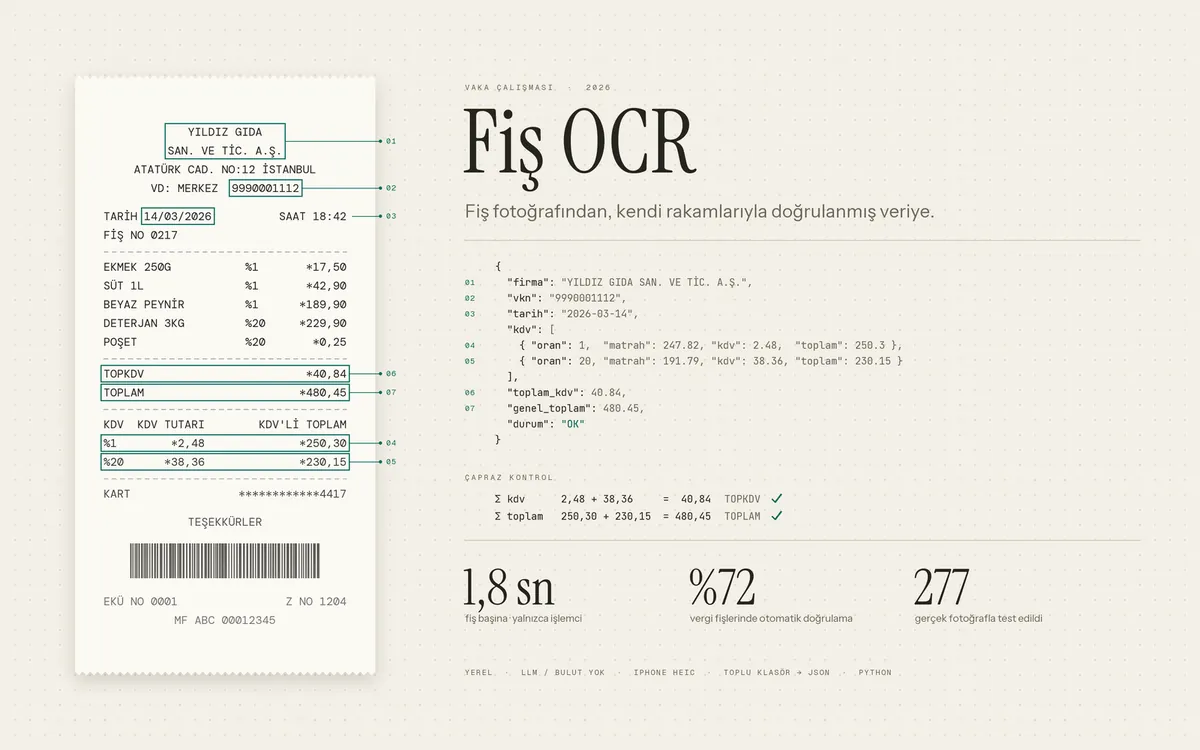
Yaklaşım: OCR + kurallar + kendi kendini kontrol
Metni okumak için yerel çalışan bir OCR motoru (RapidOCR) kullandım. Asıl iş okunan metinden doğru alanları çıkarmaktı. Bunun için kural tabanlı bir çıkarım yazdım: firma adı, VKN, tarih, KDV oranları ve toplamlar fişteki konumlarına ve kalıplarına göre bulunuyor. Dönük ya da yan yana çekilmiş fişler otomatik ayrılıyor.
En önemli karar şuydu: program emin olmadığı bir fişi sessizce yazmasın. Bir fişte KDV tutarlarının toplamı “TOPKDV” satırıyla, oran bazındaki toplamlar da genel toplamla tutmalı. Tutuyorsa fiş “doğrulandı” sayılıyor. Tutmuyorsa sonuçta “kontrol et” diye işaretleniyor. Böylece hata yapılan yer görünür oluyor, gizli kalmıyor.
Nasıl ölçtüm
277 gerçek fiş fotoğrafıyla çalıştım ve bunları baştan ikiye ayırdım: 221’i geliştirme sırasında kullandığım set, 56’sı ise kurallarımı hiç görmeyen ayrı bir test seti. Kuralları yalnızca geliştirme setine bakarak değiştirdim, test setini en sonda ölçtüm. Bu ayrım olmazsa, elinizdeki fotoğraflara göre kural yazar ve gerçekte olduğundan iyi bir sonuç raporlarsınız.
Sonuçlar:
- Vergi fişlerinde (kart slipleri hariç) fişlerin %72’si kendi rakamlarıyla otomatik doğrulandı.
- Tüm fotoğraflarda doğrulanan oranı %59. Aradaki fark büyük ölçüde KDV dökümü içermeyen kart sliplerinden geliyor.
- Fiş başına ortalama süre yaklaşık 1,7 saniye, ekran kartı olmadan, yalnızca işlemcide.
Denediğim ama bıraktığım bir şey de var: büyük fotoğrafları okumadan önce küçültmek yaklaşık %4 hız kazandırdı, ama test setinde bir sonucu değiştirdi. Küçük bir hız için doğruluğu riske atmadım, bu ayar kapalı kaldı.
iPhone fotoğrafları ve lisans
iPhone fotoğrafları HEIC biçiminde geliyor. Bunun için iki kütüphane seçeneği vardı. Birinin içinde GPL lisanslı bir kodlayıcı bulunduğu için, yalnızca okuma yapan ve LGPL lisanslı olan seçeneği kullandım. Müşteriye teslim edilen kodda lisans sürprizi olmaması da işin parçası.
Sunucuya API olarak kurulum
İkinci aşamada araç, müşterinin kendi sunucusunda (2 çekirdek, 4 GB bellek) çalışan bir HTTPS API’ye dönüştü: fotoğraf gönderilir, JSON döner. Bu aşamada önem verdiğim noktalar:
- Güvenlik: API anahtarı, dosya boyutu ve sıra kontrolü, isteğin gövdesi okunmadan önce yapılıyor. Çok büyük piksel sayılı görseller reddediliyor.
- Yük testi: Örnek fişlerle dakikada yaklaşık 19 fiş, hatasız işlendi. 12 megapiksellik telefon fotoğraflarıyla bu sayı dakikada yaklaşık 5’e düşüyor.
- Zaman aşımı: Sunucunun önündeki proxy 100 saniyeden uzun süren istekleri kesiyor. Yük testinde kuyruk uzayınca bu sınıra yaklaşıldığını gördüm ve kuyruğu fotoğraf sayısına göre sınırladım. Ardından en kötü durumdaki süre 77 saniyeye indi.
Teslimde iki rapor vardı: test sonuçlarını gösteren bir test raporu ve yük testi raporu. Kod, kurulum adımları ve API dokümanıyla birlikte teslim edildi.
Çıkardığım dersler
- Ölçüm için ayrı bir test seti en baştan ayrılmalı.
- Bir aracın “emin değilim” diyebilmesi, her şeyi okuyormuş gibi davranmasından daha değerli.
- Performans ayarları, doğruluğu değiştirmediği kanıtlanmadan açılmamalı.
Benzer bir belge işiniz varsa, birkaç örnek gönderin, ücretsiz deneyip sonucu göstereyim.